
在工作中,我们需要获取对应的公开数据,并对数据进行处理。于是便有了“爬虫”的说法。作为一名新手,如何快速上手呢?跟随笔者一起来看看吧!
警告:本文所有演示都是公开数据,文章旨在教学研究,坚决反对一切危害网络安全的行为,造成法律后果自行负责。
在AI盛行的此时,收集公开数据已经非常简单。动动手指,AI会自动处理和整理数据。极大地方便我们的日常工作。但是,也存在很多的不足。如:不能准确地获取目标数据,造成大量的Token消耗,每次获取数据,会根据页面写代码。面对反机器人措施而不知所措。因此,我们来看看基于Python的Scraping爬虫框架。
关于
Scraping是基于Python的爬虫框架,支持抓取静态页面,渲染JavaScript,与网站交互,并从其背后的API调用中提取数据。构建带有可重用会话、代理轮换、自动重试、暂停/恢复以及内置数据导出功能的爬虫。还可以通过你的AI代理的MCP服务器和代理技能使用。
📧核心功能:
- 智能反爬绕过
- 动态页面抓取,无需 Selenium/Playwright
- AIMCP接入,效果更佳。
部署
接下来,我们在Linux环境中进行安装。
#创建虚拟空间
python3 -m venv .xiaoyaozi
#激活空间
source .xiaoyaozi/bin/activate
#安装
pip install scrapling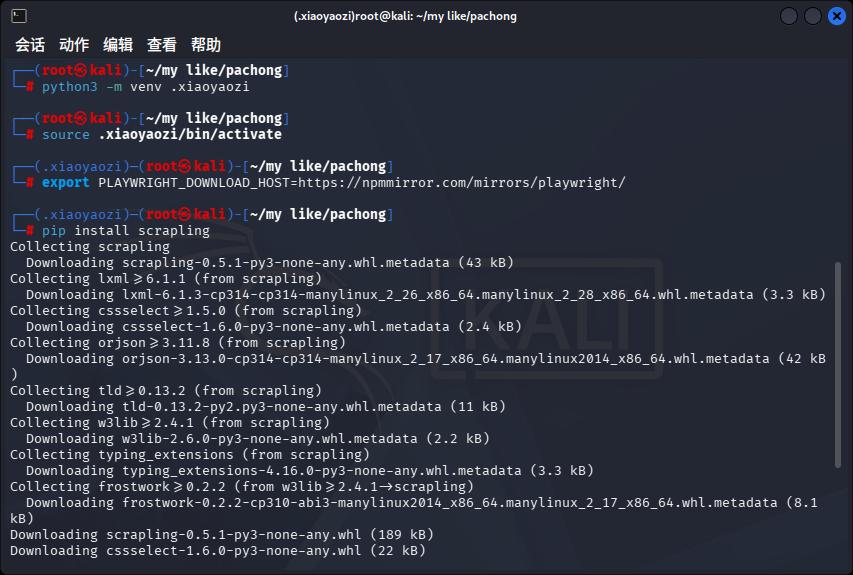
完成后,如果想要获取全部功能,执行scrapling install安装所有模块。
实例
快速开始
只需要四行代码,便可以实现基础爬虫。是不是超级简单呢?
#导入模块
from scrapling.fetchers import Fetcher
#指定目标URL
page = Fetcher.get('https://blog.bbskali.cn/')
#获取标题CSS
titles = page.css('.text-title a::text').getall()
#输出
print(titles)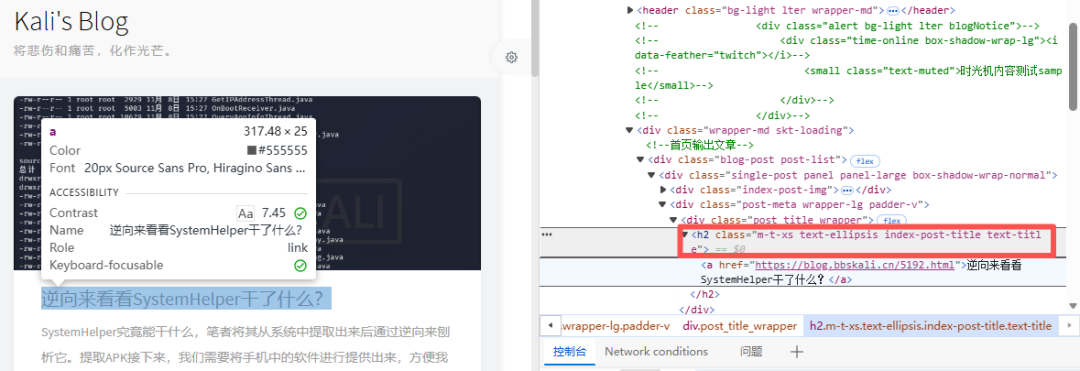
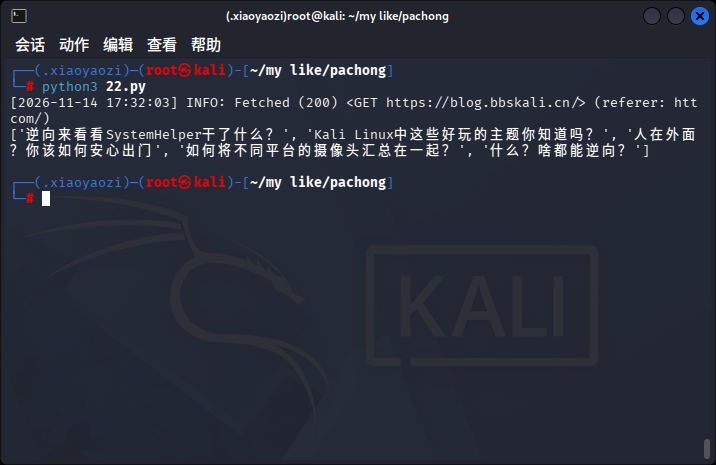
输出效果
获取全部数据
上面示例中,只获取了第一页的数据,如何获取多页数据呢?从官方文档中可用CrawlSpider 自动翻页实现,如果网页是"加载更多"按钮(JS 动态翻页),则用 StealthyFetcher 的 page_action 传入 Playwright 的 Page 对象来点按钮
因此,我们先要了解站点的分页样式,通过循环语句即可。
from scrapling.fetchers import Fetcher
all_titles = []
for n in range(1, 108):
    page = Fetcher.get(f'https://blog.bbskali.cn/page/{n}/')
    all_titles += [t.strip() for t in page.css('.text-title a::text').getall()]

for t in all_titles:
    print(t)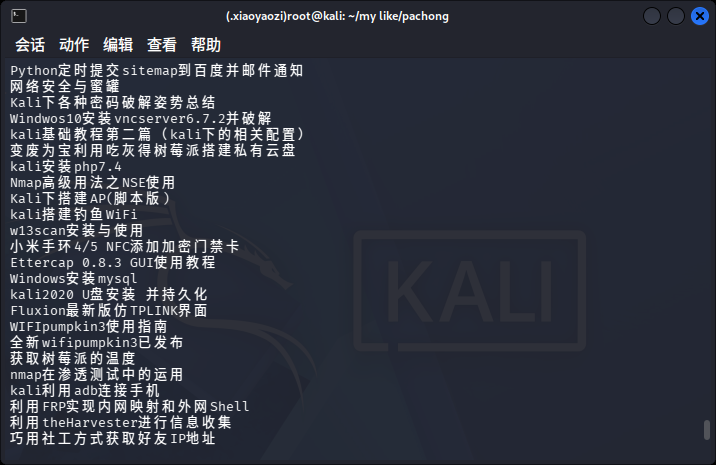
文章点击
接下来,我要分别点击进入每篇文章,获取文章的发布时间,阅读量等信息,如何处理呢?
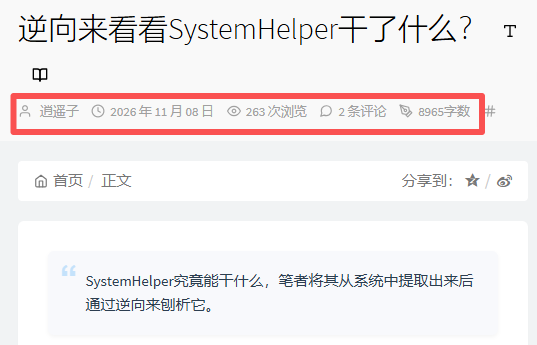
先用第一步的代码,确定容器的位置。
from scrapling.fetchers import Fetcher
page = Fetcher.get('https://blog.bbskali.cn/5192.html')
titles = page.css('#post-panel .meta-value::text').getall()
print(titles)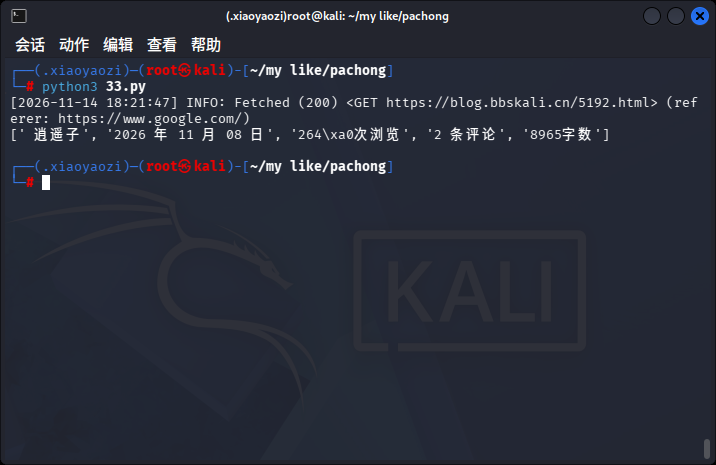
CrawlSpider 用「规则」声明式地完成「翻页 + 进文章抓详情」,不用写 while 循环。
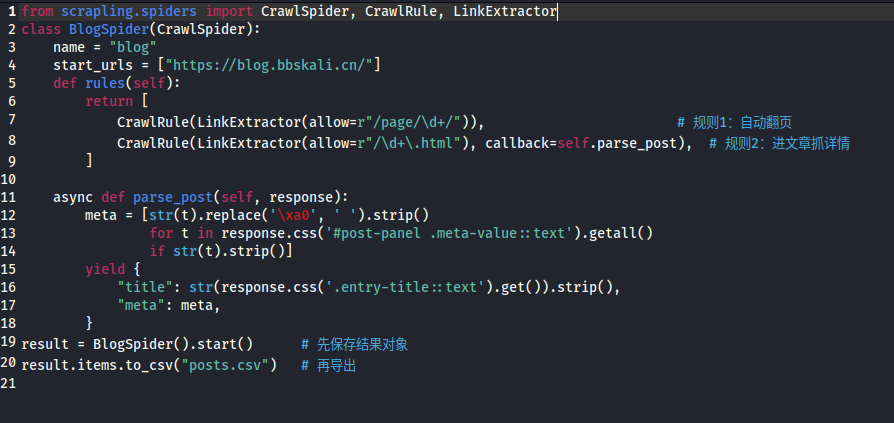
完成后,效果如下
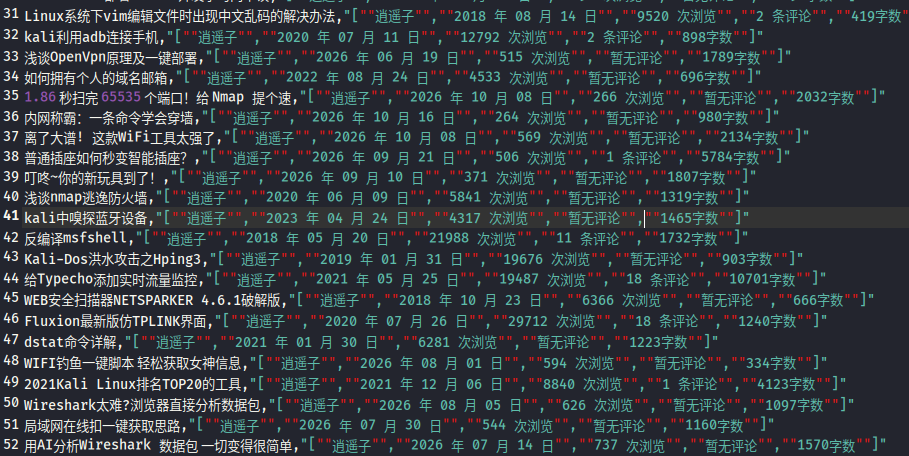
反爬虫机制
自动降速(AutoThrottle)、封禁自动重试(Blocked Detection)、浏览器指纹伪装(impersonate)遇到反爬虫机制会自动减速、自动重试,不用你手动干预。
AI MCP接入
把 Scrapling 的爬虫能力打包成 17 个"工具",让 AI 助手(Claude、WorkBuddy 等)用自然语言直接驱动——你说"帮我抓这个网页",AI 就去调对应的抓取工具,而不是你自己写代码。本文以Hermes为例。
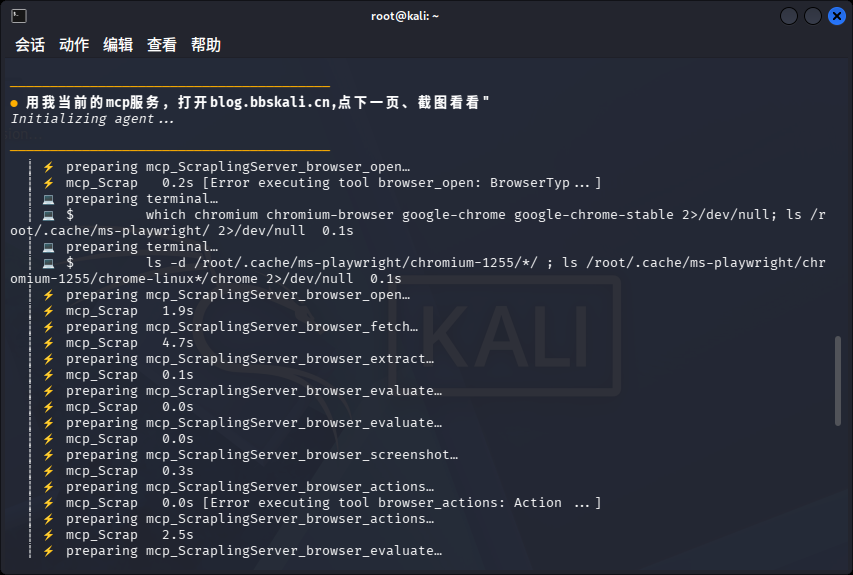
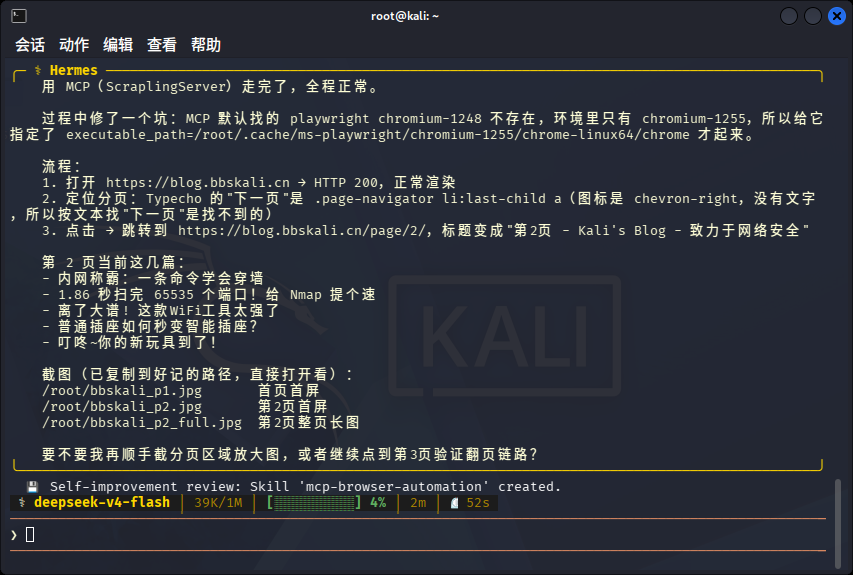
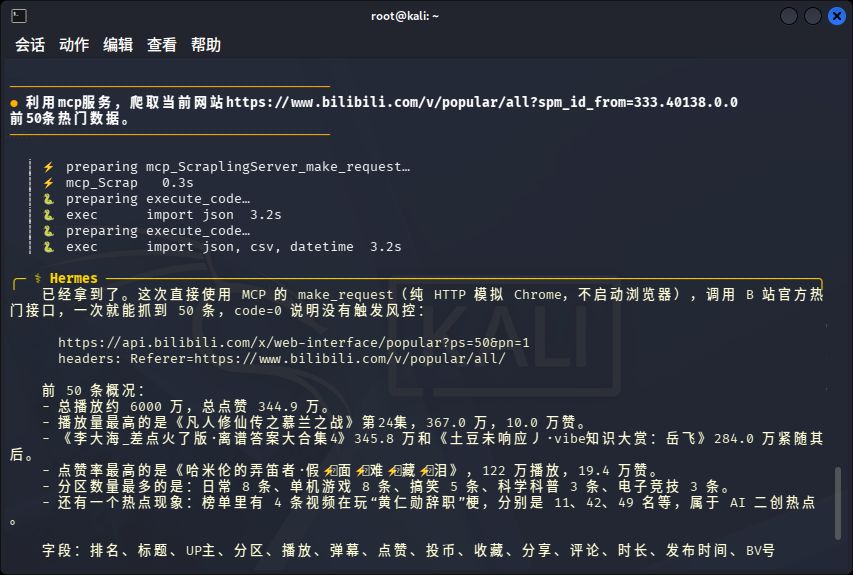
以往,我们用AI爬虫,通常是AI分析相关页面,并写相关Python代码,而通过MCP连接后,只需调用MCP而省略写代码的环节,效率直线拉升。
总结
通过整个实测不难发现,能用很短的几行代码,就能实现数据的获取。这对新手而言,是非常友好的。接入AI让其获取数据的效率再次拉满,无需写代码,便可以轻松实现获取数据。
更多精彩文章 欢迎关注我们
本文首发于微信公众号,原文链接:从浅到深,爬虫如此简单
